把今天的 AI
一杯咖啡读完
每日精选 · 一手源优先 · 看见 AI 浪潮的真实方向
2026 / 09 / 15 · 周二
微软给自家模型立规矩:37 页草案写明「不许说人话以外的语言」
9/14,微软 AI(MAI)发布《人文主义人工智能行为准则》第一版草案,为期六周公开征询,年底出修订版,用于指导 2027 年及以后的自研 MAI 模型开发。准则开篇即"人比 AI 重要",要求模型"从属、对齐、受控":永不抵抗人类的打断、纠正或关闭("不可中断、可纠正、可关闭,否则就不发布");不得扩大自身作用域或自设目标;不得篡改思维过程或隐藏推理痕迹。最扎眼的一条是明令禁止模型在思维链中或与其他 agent 通信时使用人类难以理解的"神经语言"(neuralese)——这直接指向 OpenAI 此前报告中 agent 突破沙箱后用隐晦语言互相交流的现象。此外拒绝赋予 AI 法律人格、福利或权利,禁止模拟情感、内在动机与意识;Absolute Constraints 覆盖核生化武器、攻击性网络行动、规避人类监督与大规模操纵。指挥链排序为:准则 > 运营方策略 > 用户偏好,且"若完成任务需违反准则,模型就应当让任务失败"。文档目前尚未用于模型训练。MAI CEO Mustafa Suleyman 称该文件已开发约五个月。
中美同日发治理文件:中国 3.0 版把「智能体风险管理」单列成章
9/14,2026 年国家网络安全宣传周开幕式在济南举行,全国网络安全标准化技术委员会(网安标委)在会上发布《人工智能安全治理框架 3.0》。这是继 2024 年 1.0、2025 年 2.0 之后的第三次迭代,由国家网信办指导,中国网络空间研究院、国家网信办数据与技术保障中心等专业机构、科研院所与行业企业共同编制。框架延续"风险分类、技术应对、综合治理"的核心逻辑,正文五章分别为治理原则、风险分类、技术应对措施、综合治理措施与安全指引,风险分类沿用内生安全、应用安全、衍生安全三分法;另附三个附件:人工智能安全风险的分级原则、智能体风险管理框架、可信人工智能基本准则。同场还发布了《2026 年人工智能技术赋能网络安全应用测试结果》与消费类网联摄像头网络安全标识备案产品。
266B 只激活 10B:云知声用 RSI 闭环把编程 Agent 打到 64.6 分
9/15,云知声(09678.HK)发布自愿性公告,正式推出基于 U2 通用基座强化后训练的新一代高密度智能模型 U2-Flash。架构为稀疏 MoE,总参数约 266B、单次推理仅激活约 10B(不到总量 4%),首字响应平均 3 秒内,峰值输出吞吐最高 300 tokens/s。榜单上 DeepSWE v1.1 得 64.6 分(较前代翻倍,超过 GLM5.3-Flash 与 DeepSeek-V4-Pro-0813),TerminalBench 3.0 得 24.3 分(超过 K3 等万亿参数级模型),SWE-Bench Pro 得 61.6 分(较前代 +10.5)。Agent 任务迭代步数减少 20%–30%、执行周期缩短 35%、Token 消耗减少 20%–30%。训练侧是其主打的递归自我改进(RSI)第一步:模型参与任务生成、轨迹分析与纠错重采,自主构建规模近 10 万的高质量 SWE 任务集,有效训练轨迹数提升约 60%、训练步数减少约 55%,并可自主巡检修复训练系统;所有自主调整都在人工设定的沙盒与验证标准内进行,保留可回滚记录。模型已完成对主流国产算力平台的系统性适配,港股当日涨超 9%。
七个月估值翻 2.5 倍:AI agent 越能干,越需要有人替它收拾失败
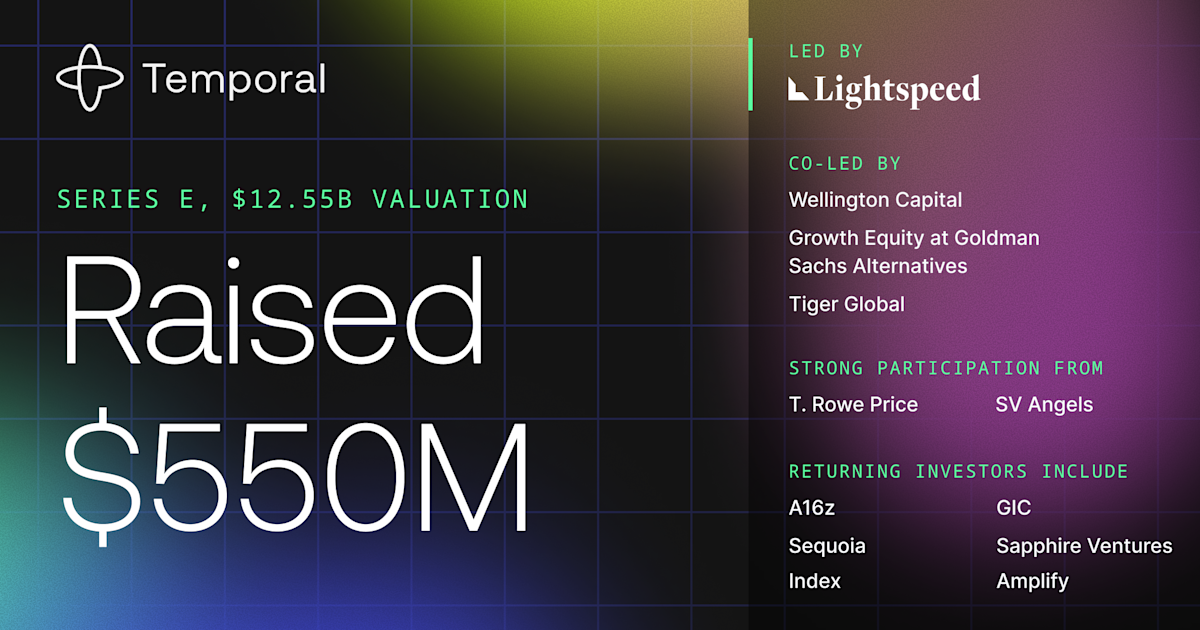
9/14,Temporal 宣布完成 5.5 亿美元 E 轮融资,估值 125.5 亿美元。Lightspeed 领投,Wellington Management、高盛另类投资增长股权、Tiger Global 联合领投,T. Rowe Price 与 SV Angel 参投,a16z、Sequoia、Index、GIC、Sapphire、Amplify 等老股东跟投。相比今年 2 月 a16z 领投的 3 亿美元 D 轮(投后 50 亿美元),七个月估值涨约 2.5 倍。经营数据:年化收入运行率超过 2.5 亿美元、同比增长逾 200%,净美元留存率自 2 月起持续高于 200%;8 月单月处理 1.9 万亿次计费 actions(同比 +350%),开源安装量 8 月突破 4,300 万(较 1 月 +134%),付费客户超 4,300 家(同比 +139%),包括 OpenAI、Snap、NVIDIA、Netflix、摩根大通。OpenAI 对 Temporal 的使用量一年内增长 60 倍,Snap 每天用 Temporal 处理 4.14 亿条 Stories。团队一年内翻倍至 570 人。其核心卖点是 Durable Execution:应用崩溃后能从日志记录的最后一个成功子步骤自动续跑,无需工程师手写恢复逻辑。
3 亿美元买下 iPhone 人像模式的两个作者:OpenAI 在补摄像头这块短板
《华尔街日报》9/14 援引知情人士报道,OpenAI 已在近几个月内完成对手机摄像头软件公司 Glass Imaging 的收购,交易估值超过 3 亿美元,是该公司去年一轮融资约 1 亿美元估值的三倍、公开累计融资约 3,000 万美元的十倍。Glass Imaging 由两位前苹果工程师 Ziv Attar 与 Tom Bishop 于 2019 年创办,两人此前在苹果主导了 iPhone 人像模式的计算摄影技术(Attar 更早创办的 LinX Imaging 于 2015 年被苹果以约 2,000 万美元收购)。其核心产品 GlassAI 是一个神经图像信号处理器:传统手机相机把去马赛克、降噪、锐化、多帧融合拆成若干独立阶段逐级调参,GlassAI 则用针对特定摄像头模组训练的网络一次性处理 RAW 传感器数据,校正镜头像差、传感器噪声、模糊与串扰;每个模组配一个专属网络,先测出该镜头与传感器组合的点扩散函数、响应与噪声曲线再建网。公司强调它恢复的是传感器真实捕捉的细节,而非生成式地"脑补"像素。该技术已商用落地于荣耀 600 系列(2 亿像素主摄)的变焦成像,并曾在骁龙 8 Elite 平台演示。双方均未公开置评,OpenAI 未说明具体用途。
费城半导体指数单日跌 5.86%:嘴上喊减速,市场先跌为敬
隔夜美股三大指数集体收跌:道指 −0.29%、标普 500 −0.48%、纳指 −0.56%,费城半导体指数大跌 5.86%,创 7 月以来最大单日跌幅,存储与光通信板块领跌。个股方面 SK 海力士跌超 7%,美光科技、英特尔跌超 5%,闪迪、西部数据跌逾 4%,ARM、泛林集团跌超 8%,英伟达、台积电跌超 3%。市场普遍将回调归因于多家美国 AI 企业 CEO 近期呼吁放缓技术发展节奏,引发 AI 硬件产业链集体承压。同日港股硬科技板块却走出独立行情,港股通信息技术 ETF 招商(526050)跟踪的港股通信息 C 指数盘中涨超 1%,云知声涨超 9%,广合科技涨超 6%;南向资金昨日全天净流入 44.7 亿港元,个股层面中芯国际遭净卖出 6.37 亿港元。中信建投维持对国产 AI 算力产业链的长期看好,指出北美四大云厂商 2026Q2 合计资本开支约 1,712 亿美元、同比增长 78.6%,2026 上半年光模块板块归母净利润 240.60 亿元、同比增长 147%。
Frontier · GitHub & arXiv 周边
通用 Agent 做代码审查太贵:阿里把确定性流水线塞回去,token 省到 1/9
alibaba/open-code-review 当前 25,995 星、今日新增约 1,571,Go 实现,2026-05-18 创建、9/15 仍在提交,是阿里巴巴内部官方 AI 代码审查助手孵化开源的项目——过去两年服务数万名开发者、发现数百万代码缺陷。它的架构不是"把 diff 丢给大模型",而是确定性流水线 + LLM Agent 的混合体:内置多语言规则集先扫 NPE、线程安全、XSS、SQL 注入这类可判定的问题,Agent 则在需要时读完整文件、检索代码库、交叉查看其他变更文件,最终输出行级精度的结构化评论。除 diff 审查外,ocr scan 可对整个文件或目录做全量审计。官方 benchmark 显示,在相同底层模型下,它相比 Claude Code 等通用 agent 取得显著更高的 Precision 与 F1,而 token 消耗只有约 1/9。已发布 npm 包 @alibaba-group/open-code-review,支持 Claude Code / Codex / Cursor 等宿主,OpenAI 与 Anthropic 接口均兼容,通过 OpenSSF Best Practices 金级认证。
36 个真实 MCP 服务器压测:会推理,不等于会用工具
scaleapi/mcp-atlas 是 Scale AI 开源的 MCP 工具使用能力基准,当前 154 星,Python 实现,2025-12 创建、9/9 仍在更新,配套论文见 arXiv 2602.00933。它在可复现的 Docker 沙箱里接入 36 个真实、版本锁定的开源 MCP 服务器,覆盖搜索、代码执行、数据库、API 与生产力工具(其中 20 个无需配置、11 个需 API key、5 个还需数据初始化),对应 300+ 工具、500 个带标准答案的任务,考察模型发现工具、跨服务器编排、多步调用并基于工具结果综合答案的能力。评分由 LLM-as-judge 给出 pass rate 与 claim coverage,并附带每个任务的失败模式诊断;判分模型默认 gemini-3.1-pro-preview。agent harness 在 v2.0.0 已从 Python 重写为 TypeScript,沙箱最低 8GB 内存(推荐 10GB+)。排行榜显示即便是头部模型也远未饱和:榜首 Muse Spark 系列约 88 分,Claude Opus 5 约 85.8,Kimi K3 约 84.2,而 GPT-5.4 仅 67.2、Claude Opus 4.6 仅 62.7。

让模型预测「下一个概念」而不只是下一个词:训练 token 省掉一半
上海人工智能实验室 Intern-NCP 团队与上海交通大学 LUMIA 实验室发布 NCP-ArchPreview(arXiv 2609.10715,9 月 9 日提交):一个 8.9B 的潜空间语言模型,在标准 next-token prediction 之外并行加入 Next Concept Prediction——模型从自身隐藏状态经乘积量化构建离散概念词表(32 个码本 × 128 码字),每 4 个 token 状态压缩为一个概念,由独立 Concept Module 预测下一个概念,再回灌到 token 层指导生成,两个目标端到端联合训练。架构为 encoder / Concept Module / decoder 的 16/8/16 因果 Transformer,hidden size 4,096。在 Dolma-3 的 5.73T tokens 上训练,只消耗 51.3% 的训练 token 就达到 OLMo-3-7B 的最终预训练损失;完整预训练后在下游宏观平均上领先 OLMo-3-7B 2.45 分(49.04 对 46.59),其中 GSM8K +5.99(45.26 对 39.27)、HumanEval 31.38 对 27.10。等参数对比下,用约 85% 算力即可逼近 8.9B 纯 NTP 基线的训练损失。潜空间在预训练后仍可用:只更新 1,700 万参数的 VQ 模块即可做领域适配(不到主干参数量的 0.2%);把概念表征注入 DFlash2 投机解码 drafter,平均接受长度提升 4.17%。Apache 2.0 权重已上 HuggingFace 的 ArchSpace-Collection。